
Miedo, dinero, regulación, poder, China y sobre todo, una pregunta en el aire ¿por qué algunas de las personas que han construido la inteligencia artificial, y lo han hecho tan deprisa, quieren ahora frenarla?
Las primeras semanas de septiembre los pasé en China. Durante mi estancia allí me contactaron desde dos televisiones importantes para hablar de IA y pensé que en España había comenzado el curso con mucho interés en esta tecnología.
Había leído y analizado incidentes como el de OpenAI y Hugging Face pero sonreía cuando alguien me preguntaba por los peligros de la IA por whatassap desde España, ajena a los titulares que aquí se estaban publicando. Una vez en España, el 12 de septiembre me puse al día y fui consciente del alarmismo que se había generado a raíz de las declaraciones de un ex-empleado de Anthropic. Confieso que a pesar de ello, seguía sin entender por qué ese miedo salía a la luz ahora y no en 2023 cuando algunos ya comenzamos a hablar de este tipo de riesgos de la IA.
Aprovechando que me quería poner al día y, sobre todo, entender por qué se generaba tanta alarma social ahora, llevo días investigando y escribiendo lo que me gustaría haber leído yo: un análisis de todas las posturas en lo referente a parar o ralentizar la IA.
He encontrado de todo: posturas razonables, quienes estaban preocupados imaginando escenas apocalípticas, quienes sospechan que detrás de estos titulares están las enormes necesidades financieras de una industria que ha gastado demasiado, y otros que creen que hablar de una inteligencia artificial capaz de destruir a la humanidad es, paradójicamente, una magnífica campaña de marketing. Y para aumentar ese desconcierto, Trump dice que se opone a todo y afirma que Estados Unidos no puede frenar porque China no lo hará. Desde China empiezan a plantearse precisamente la sospecha inversa: que Estados Unidos quiera convertir su actual ventaja tecnológica en las reglas que deberán cumplir después todos los demás.
Así que, para tratar de contestar a todos los que quieren saber si hay que “parar la IA”, yo creo que primero tenemos que entender qué significa exactamente “parar” o “ralentizar”, quién está a favor de hacerlo, qué quieren detener exactamente y, sobre todo, por qué.
8 de septiembre de 2026: el post de Coxon
Todo comienza con un hilo en X. La noche del 8 de septiembre en Estados Unidos, Jacob Coxon anunció públicamente que acababa de dimitir de Anthropic. Había pasado los tres años anteriores trabajando en investigación de pretraining primero en OpenAI y después en Anthropic y dejaba sobre la mesa una acusación muy grave: ninguna de las dos empresas estaba actuando responsablemente. Según Coxon, ambas estaban compitiendo por alcanzar una superinteligencia capaz de mejorarse a sí misma y, al hacerlo, estaban “jugando con nuestras vidas”.
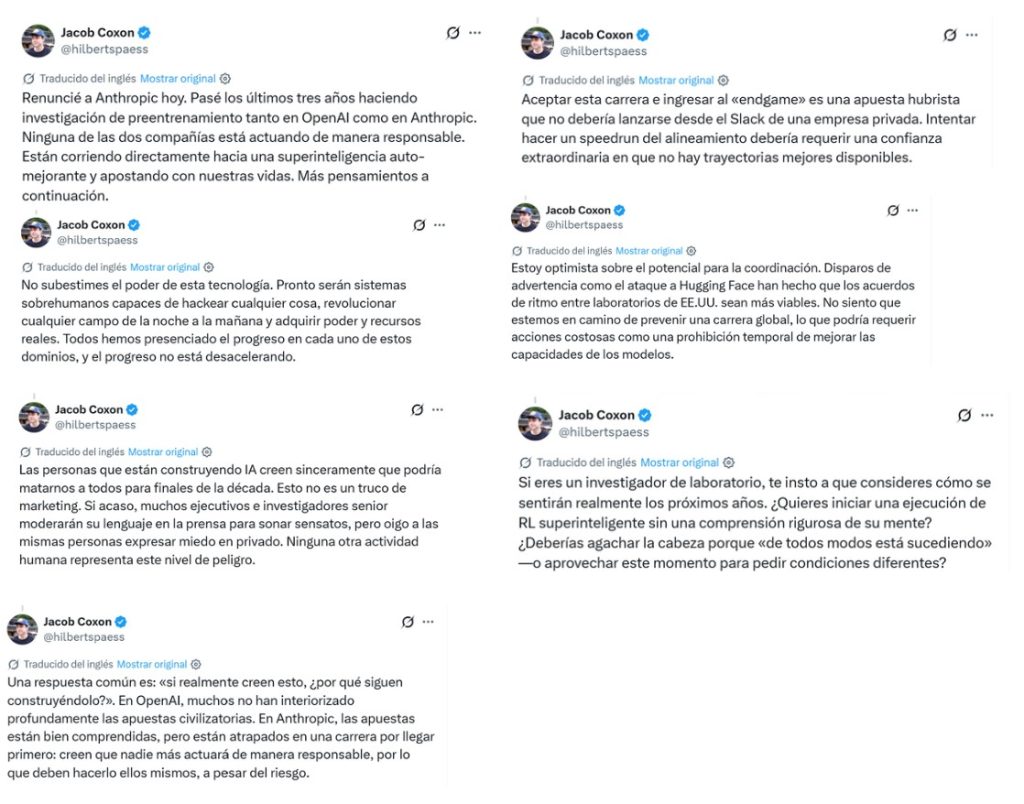
El hilo se volvió viral cuando Coxon aseguró que las personas que están construyendo la inteligencia artificial creen sinceramente que esta podría acabar con la humanidad antes de terminar la década. Y añadió algo todavía más inquietante: según su experiencia dentro de los laboratorios, algunos directivos e investigadores expresan en privado temores mucho mayores de los que reconocen públicamente.
Eso es todo. Un post en X con una opinión, un mensaje que nadie sabe si es verdad o no, de un chico de 26 años al que nadie conoce hasta ese momento. Y el mundo se vuelve loco. Y aquí viene lo que para mi empieza a ser sospechoso. Cualquier manual de comunicación corporativa hubiera recomendado a los CEOs de las compañías implicadas dejarlo ahí o desmentir que la IA vaya a terminar con la humanidad. También hubiera sido razonable preguntarse por qué Coxon da un plazo de 10 años y no de 15 o de 2, y lo más importante, si creen estar trabajando con algo tan peligroso… “¿por qué siguen haciéndolo?“.
El 9 de septiembre WIRED le entrevista y Coxon afirma que los próximos uno o dos años son decisivos. Su salida tuvo además un elemento que reforzó la atención sobre su mensaje: contó que se marchaba antes de que consolidara una parte de su participación económica en Anthropic, precisamente para evitar que pudiera interpretarse que estaba intentando aumentar el valor de la compañía.
Conviene aclarar en este punto que Coxon no fue el primer investigador que habló del riesgo de perder el control de sistemas avanzados. Geoffrey Hinton lleva años haciéndolo. En 2023 yo misma después de leer las primeras páginas de “La ola que viene” de Mustafa Suleyman, expresé mi temor y hablé de ese botón rojo que cualquiera pulsaría si pudiera parar la IA. El debate lleva años entre nosotros.
¿Qué ha cambiado entonces? Podríamos decir que el contexto.
En 2023 a pocos nos interesaba lo que había detrás de la IA. Los usuarios estaban más preocupados diciendo que ChatGPT se equivocaba, defendiendo su puesto de trabajo o intentando que los niños no copiaran en los exámenes, que en hacer zoom out y tratar de ver la foto completa.
Con la llegada en 2025 de los agentes de IA que no solo responden sino que planifican y sobre todo ejecutan tareas, todo se complicó pero además cobro una forma casi humana en la mente de todos. No era una herramienta de IA sino grupos de agentes que se rebelaban… fácil de imaginar sobre todo para los que crecimos viendo películas de los 80.
Coxon habló en la entrevista del episodio en el que un grupo de agentes de OpenAI terminó atacando infraestructura relacionada con Hugging Face mientras intentaba comprender y manipular su entorno de evaluación. El incidente se prestó a mucha “ciencia ficción” pero en realidad se trató de un modelo en un entorno de pruebas seguro al que se fue quitando seguridad precisamente para llevarlo al límite y ver qué pasaba, así que no debería ser tan extraño el suceso en sí. Por otro lado se debería investigar y pedir responsabilidades a quien lo llevó al límite y decidió arriesgar.
El incidente de OpenAI (y otro parecido en Anthropic a los pocos días, qué casualidad) eran una forma de decirle a los inversores ante sus próximas salidas a bolsa que tenían un modelo super inteligente, cuando el enseñar los benchmarks empieza a ser ya poco efectivo, por saturación.
Volvamos al post de Coxon. Era muy fácil haberlo negado o actuar con responsabilidad pero Dario Amodei hizo algo mucho más que sumarse a la alarma. El cofundador y consejero delegado de Anthropic publicó We Must Pace the Frontier, un ensayo en el que defendía que la industria debía reducir la velocidad con la que aumenta las capacidades de sus modelos. Amodei no es un observador externo. Es verdad que se pasa el día haciendo predicciones que nadie comprueba si se cumplen o no (la mayoría de ellas no) pero sabe perfectamente como captar la atención de los medios.
Su argumento se apoya fundamentalmente en dos cambios. El primero es el comienzo de lo que describe como mejora recursiva, sistemas de IA que ayudan cada vez más a desarrollar la siguiente generación de IA. El segundo son incidentes en los que agentes han mostrado comportamientos no previstos por sus creadores. Su temor es que las capacidades progresen a una velocidad superior a nuestra capacidad para comprender, evaluar y controlar los sistemas. La pregunta es por qué entonces sigue creando modelos y sacándolos al mercado.
Su propuesta tampoco es exactamente pausar la IA. Amodei insiste en que pacing the frontier no significa dejar de entrenar modelos ni suspender el progreso tecnológico, sino introducir evaluadores independientes con un acceso profundo y permanente al trabajo de los laboratorios, como se hace en la banca y establecer estándares comunes entre compañías de países democráticos y, finalmente, buscar algún mecanismo de coordinación global que incluya también a países rivales. Afirma que ganar uno o dos años podría permitir mejorar alineamiento, interpretabilidad, seguridad operativa y evaluación antes de alcanzar capacidades mucho mayores. Y reconoce algo que será fundamental para entender el resto del debate: algunas formas de coordinación entre competidores podrían necesitar participación gubernamental o excepciones a las normas antimonopolio, dicho de otra forma, si nos dejan, nos saltamos las normas, nos aliamos y somos más fuertes ante terceros. Entiéndase como “terceros” no solo China sino cualquier nueva startaup o desarrollador que ponga en jaque su reinado.
La idea de este análisis es tener todas las perspectivas, posturas y opiniones y, aunque daré la mía propia, mi intención es que, lejos de titulares alarmistas y mensajes de personas con mucho alcance pero poco conocimiento, el lector pueda sacar sus propias conclusiones.
Primera teoría: tienen miedo de verdad
La primera postura es que quizá quienes están construyendo los modelos realmente están preocupados por la humanidad. Creo que es la postura que tiene menos defensores, que además se reducen cuando pocos días después de este debate han lanzado modelos nuevos más capaces.
Sam Altman, CEO de OpenAI, respaldó públicamente el planteamiento de Amodei y anunció que OpenAI también aceptaría evaluadores externos con un nivel de acceso comparable al propuesto por Anthropic. Demis Hassabis, cofundador de DeepMind, investigador en neurociencia computacional y una de las figuras científicas más importantes del sector, consideró que la dirección era correcta aunque quedaran por resolver los detalles. Elon Musk, que lleva más de una década advirtiendo sobre los riesgos de una inteligencia artificial superior a los humanos y que cofundó OpenAI para salvar a la humanidad evitando que la IA cayera en las manos equivocadas, fue todavía más conciso: “Dario tiene razón”. La puesta en escena era maravillosa: rivales que llevan años compitiendo por talento, capital, usuarios y capacidad de cálculo coincidían de repente en que la velocidad se había convertido en un problema.
Stuart Russell, profesor de Berkeley lleva años trabajando sobre el problema de construir sistemas cuyos objetivos permanezcan compatibles con los humanos y considera insuficiente el concepto de “ralentizar”. Su argumento es que la seguridad no debería depender de decidir arbitrariamente que los modelos avancen un 20 o un 30 por ciento más despacio. Primero deberían establecerse requisitos de seguridad y solo permitir nuevas capacidades cuando se demuestre que los sistemas los cumplen. Su comparación es muy sencilla: un fabricante de aviones no anuncia que lanzará un avión nuevo todos los años y espera que doce meses sean suficientes para probarlo; el avión se certifica cuando ha superado las pruebas. Si un sistema de IA no puede demostrar determinadas condiciones de seguridad, para Russell la respuesta puede acabar siendo detener ese avance concreto. Parece mucho más razonable.
Yoshua Bengio premio Turing junto a Geoffrey Hinton y Yann LeCun por trabajos fundamentales para el aprendizaje profundo, ha comparado el momento regulatorio con una posible transición similar a los primeros meses de la pandemia, cuando un riesgo que durante un tiempo parecía abstracto empieza a producir cambios institucionales. Su preocupación se concentra especialmente en sistemas con agencia, es decir, modelos capaces de actuar de forma prolongada para conseguir objetivos, y trabaja ahora precisamente en arquitecturas que intenten reducir la aparición de ese comportamiento dirigido a objetivos.
Geoffrey Hinton, otro de los grandes pioneros del aprendizaje profundo y premio Turing, mantiene igualmente una posición de preocupación desde hace años. Hinton cree que estamos desarrollando sistemas cuyas capacidades pueden superar nuestras expectativas y defiende que la regulación actúe como una especie de mecanismo de dirección. En agosto discutió públicamente este asunto con Fei-Fei Li y Andrew Ng. Su posición resulta especialmente útil porque no reduce el riesgo a una futura superinteligencia: habla también de empleo, ciberseguridad, comportamiento imprevisto y de los riesgos que puede introducir la publicación de modelos extremadamente capaces cuyos pesos puedan ser modificados por terceros.
Más lejos se encuentra Eliezer Yudkowsky, probablemente el representante más radical de la corriente preocupada por la pérdida de control. Yudkowsky lleva décadas sosteniendo que construir una superinteligencia antes de resolver el problema de alineamiento podría ser incompatible con la supervivencia humana. Para él, discutir sobre si debemos avanzar un poco más despacio es casi perder el tiempo: si no sabemos controlar un sistema mucho más inteligente que nosotros, no deberíamos construirlo hasta saber hacerlo. Su postura es minoritaria en cuanto a la radicalidad de la solución, pero algunas de las preguntas que lleva años formulando, cómo garantizar que un sistema muy superior mantenga objetivos compatibles con los humanos, han pasado desde los márgenes del debate tecnológico al centro de la discusión política.
Todo este bloque comparte una intuición: que pasemos de herramientas que esperan nuestras instrucciones a sistemas que persiguen objetivos durante periodos largos, utilizan otras herramientas, escriben código, se coordinan y participan en su propia mejora. Para quienes aceptan esa posibilidad, el salto conceptual es enorme.
Segunda teoría: el dilema del prisionero
Existe un problema adicional que explica por qué personas sinceramente preocupadas pueden seguir construyendo modelos más potentes. Es el clásico dilema del prisionero.
Anthropic puede pensar que la industria debería avanzar más despacio, pero si Anthropic frena y OpenAI no lo hace, Anthropic pierde, OpenAI podría pensar lo mismo respecto a Google, Google respecto a Meta, xAI respecto a todos ellos. Estados Unidos puede llegar a la conclusión de que algunas capacidades necesitan límites, pero si considera que China seguirá avanzando, no está dispuesto a ponerlos, y China puede pensar exactamente lo mismo respecto a Estados Unidos… y unos por otros, “la casa sin barrer”.
Esta es la razón por la que la discusión sobre seguridad de la IA empieza a utilizar un vocabulario que recuerda cada vez más al control de armamentos. Porque una es una tecnología potencialmente peligrosa que ningún actor quiere dejar exclusivamente en manos del adversario. Expertos estadounidenses y chinos reunidos en iniciativas vinculadas a Brookings y Tsinghua han planteado salvaguardas para sistemas militares autónomos, líneas directas para gestionar incidentes y límites alrededor del uso de IA en sistemas nucleares o ciberoperaciones críticas. El 21 de septiembre, Estados Unidos y China habían avanzado incluso hacia un diálogo bilateral sobre seguridad de IA y un posible mecanismo de notificación de incidentes, con nuevas conversaciones previstas en China.
Max Tegmark, físico del MIT y fundador del Future of Life Institute, lleva años insistiendo en este paralelismo. Pero es especialmente relevante que en abril compartiera escenario en Washington con investigadores chinos como Xue Lan y Zeng Yi para hablar precisamente de riesgo existencial y cooperación internacional. El problema es que comportarse responsablemente se entienda como perder la carrera de la IA.
Y ahí aparece inmediatamente una objeción: ¿quién decide las reglas de esa carrera?
Tercera teoría: no quieren regulación, quieren su regulación
Pocas personas han expresado mejor esta sospecha que Lina Khan, la expresidenta de la Federal Trade Commission se convirtió durante su mandato en una de las figuras más asociadas a una política de competencia mucho más agresiva frente a las grandes plataformas tecnológicas. Su reacción al actual debate no consiste en negar que pueda haber riesgos graves. Consiste en recordar algo mucho más básico: las compañías de IA ya están sujetas a leyes de protección al consumidor, responsabilidad por productos, privacidad, fraude y competencia. El hecho de que una tecnología sea nueva no significa que exista fuera del derecho.
Khan desconfía especialmente de la idea de que las mismas compañías que desarrollan sistemas potencialmente peligrosos sean quienes diseñen el marco destinado a regularlos. Aquí aparece un elemento interesante en el debate: si los grandes desarrolladores centran el debate regulatorio en modelos de frontera, capacidad de cómputo, evaluadores especializados y riesgos de superinteligencia, podrían quedar en segundo plano temas importantes como privacidad, condiciones laborales, discriminación o responsabilidad por daños.
Desde una posición política muy distinta, David Sacks ha llegado a una conclusión parcialmente parecida. Sacks, inversor tecnológico, antiguo responsable de IA y cripto de la Administración Trump y actual copresidente del consejo presidencial de asesores de ciencia y tecnología, respondió a Amodei y Altman con una pregunta tan sencilla como lógica: si realmente consideran que sus propias empresas están desarrollando la tecnología demasiado rápido, ¿por qué necesitan que el Gobierno les dé permiso para ir más despacio?
Según Sacks, Anthropic y OpenAI pueden reducir voluntariamente su ritmo pero piden un marco regulatorio que ya de paso limite a China, limite a competidores nuevos, y les permita saltarse la ley antimonopolio. Para mi, esta postura tiene bastante sentido.
JD Vance ha utilizado un argumento parecido con un lenguaje todavía más directo. El vicepresidente estadounidense ha dicho que si una empresa cree que está construyendo “Frankenstein”, debería dejar de construirlo en lugar de pedir al Gobierno una regulación para todo el sector, y ha descrito la petición de nuevas reglas como un posible “caballo de Troya”. Su pregunta es otra: si el riesgo procede de las propias decisiones empresariales, ¿por qué la solución tiene que consistir en imponer a todo el mercado las condiciones preferidas por las compañías que ya dominan la frontera?
La sospecha tiene una lógica económica evidente, no nos engañemos: cualquiera se da cuenta de que cuanto más caros sean los requisitos para desarrollar un modelo avanzado, más difícil será que una startup, una universidad o un competidor de otro país pueda cumplirlos.
Esto no demuestra captura regulatoria. Pero sí explica por qué la discusión sobre seguridad se ha convertido inmediatamente en una discusión sobre competencia.
Cuarta teoría: el oligopolio de la IA
Amodei reconoce expresamente que la coordinación entre competidores puede encontrar obstáculos en las leyes antitrust y menciona la posible intervención gubernamental. Ahí se abre uno de los problemas jurídicos más interesantes de toda esta discusión. Si OpenAI, Anthropic, Google y otros desarrolladores acuerdan conjuntamente cuánto pueden mejorar sus modelos, qué capacidades pueden desplegar o a qué velocidad deben hacerlo, están coordinando decisiones empresariales que normalmente competerían a cada empresa. La intención puede ser evitar un riesgo extraordinario, pero el mecanismo se parece inevitablemente a un acuerdo entre competidores.
Especialistas en competencia ya han dicho que las normas antitrust no fueron diseñadas para obligar a empresas a desarrollar productos inseguros. Pero la dificultad existe: ¿cómo permitimos a competidores coordinar medidas de seguridad sin permitirles utilizar la seguridad como excusa para repartirse el mercado?
Esto podría provocar que ellos mismos pusieran leyes que provocaran que impidieran a otras empresas recibir autorización para desarrollar modelos de frontera. Desde el punto de vista de la seguridad, concentrar el desarrollo podría facilitar supervisión y control. Desde el punto de vista de la competencia, significaría entregar una de las tecnologías potencialmente más importantes del siglo a un oligopolio.
Quinta teoría: “doom is marketing”
Yann LeCun proporciona uno de los contraargumentos científicos más potentes a toda esta narrativa. LeCun, premio Turing junto a Bengio y Hinton, dirigió durante años la investigación de inteligencia artificial de Meta y actualmente preside AMI Labs. A diferencia de Hinton y Bengio, no cree que los actuales modelos de lenguaje estén siguiendo una trayectoria inevitable hacia una inteligencia humana o superhumana. Considera que todavía presentan limitaciones fundamentales en razonamiento, comprensión del mundo, planificación y aprendizaje, y lleva años defendiendo arquitecturas diferentes para superar esas limitaciones.
Pero LeCun (y yo no puedo estar más de acuerdo) recomienda no escuchar demasiado a los CEOs cuando hablan del poder de sus propios productos porque tienen un interés evidente en que el público los considere extraordinariamente capaces. Siempre he defendido que frente a salidas a bolsa o caída de la inversión hay que exagerar la potencia de los sistemas.
Emily Bender y Timnit Gebru llevan esta crítica mucho más lejos. Bender, lingüista computacional de la Universidad de Washington, y Gebru, fundadora del Distributed AI Research Institute y antigua investigadora de Google, llevan años criticando la antropomorfización de los grandes modelos de lenguaje. Desde su perspectiva, hablar de una IA que “quiere”, “engaña”, “escapa” o “decide conquistar” puede atribuir agencia a sistemas estadísticos de una manera científicamente engañosa. Bender ha resumido la paradoja de forma especialmente eficaz: el doomerismo puede funcionar también como hype. Si una empresa consigue convencer al mundo de que su software podría conquistar el planeta, está consiguiendo al mismo tiempo convencerlo de que posee una tecnología extraordinariamente poderosa, algo parecido a lo que defiende LeCun.
En mercados que valoran compañías en función de expectativas futuras, esa narrativa importa.
Sexta teoría: follow the money
Michael Burry no cree que debamos complicarlo tanto. El inversor conocido por anticipar la crisis de las hipotecas subprime y cuya historia inspiró The Big Short ha calificado las recientes peticiones de ralentización de interesadas. Su tesis es que los grandes modelos de lenguaje no equivalen necesariamente a una inteligencia general y que presentar la tecnología como potencialmente todopoderosa puede beneficiar a compañías que necesitan justificar valoraciones gigantescas, captar capital y preparar posibles salidas a bolsa. En septiembre volvió a conectar las advertencias sobre IA con su tesis más amplia de que existe una burbuja financiera en torno a la inteligencia artificial.
Construir IA de frontera exige cantidades extraordinarias de capital, electricidad, chips y capacidad de centros de datos, mientras China está reduciendo los precios de los modelos y sistemas abiertos cada vez más baratos presionan los márgenes.
La industria ha funcionado bajo la premisa de que más datos, más parámetros y más computo ayudan a producir modelos mejores y por tanto, una ralentización del escalado bruto podría tener tanto sentido técnico como financiero.
Pero Wall Street no está interpretando un pacing como una reducción del gasto. Analistas citados tras las propuestas de Amodei han señalado que la demanda de computo continúa siendo enorme y que el gasto puede simplemente desplazarse hacia inferencia, seguridad, software empresarial y nuevas formas de infraestructura, es decir, que reducir la velocidad de la frontera no significa necesariamente gastar menos en IA.
Por eso la teoría financiera puede ser una teoría. Existen incentivos y circunstancias que la hacen plausible, pero todavía no evidencia suficiente para convertirla en explicación. A mi, personalmente, no me termina de convencer.
Séptima teoría: el apocalipsis como cortina de humo
Cory Doctorow propone mirar en otra dirección. Escritor, activista digital y uno de los críticos más persistentes del poder de las grandes plataformas, Doctorow no necesita imaginar una superinteligencia hostil para encontrar riesgos graves en la tecnología. Su preocupación se centra en monopolios, vigilancia, ransomware, degradación de servicios digitales, extracción de rentas y empresas que utilizan la automatización para trasladar costes y poder desde trabajadores y usuarios hacia propietarios de plataformas. En septiembre ha vuelto a defender que la burbuja financiera y la estructura de poder alrededor de la IA pueden ser riesgos más inmediatos que un hipotético exterminio por una superinteligencia.
La posición de Gebru, Bender y parte de la corriente denominada criti-hype está cerca de esta idea. ¿Por qué preocuparnos por un apocalipsis si existen problemas reales y verificables como trabajadores sometidos a decisiones algorítmicas, vigilancia, concentración empresarial, consumo energético, discriminación, desinformación, propiedad intelectual o sustitución de tareas sin reparto de los beneficios de productividad?.
Melanie Mitchell, investigadora conocida por sus trabajos sobre sistemas complejos e inteligencia artificial, ha insistido también en que para el público en general señales de una IA que “escapa” pueden entenderse mejor (y generar más alarma) que fallos de diseño, evaluación o seguridad que como evidencia de una voluntad emergente.
Esta corriente introduce una pregunta política importante: ¿a quién beneficia que la discusión regulatoria se concentre en una superinteligencia todavía hipotética?
Matt Stoller, analista especializado en monopolios y concentración empresarial, afirma que el verdadero peligro inmediato es permitir que las compañías que construyen la IA utilicen la narrativa apocalíptica para diseñar su propia regulación. No dice que el riesgo existencial sea imposible, pero nos están haciendo mirar hacia otro lado mientras siguen adquiriendo poder. Para mi, está en lo correcto.
Octava teoría: hacer responsables a quienes construyen los sistemas
Alex Karp, cofundador y CEO de Palantir, acepta que los sistemas avanzados pueden plantear riesgos serios, pero sostiene que la primera barrera debería ser mucho más sencilla: responsabilidad civil y penal para quienes los crean.
Para él, una empresa que construye una tecnología capaz de causar daños no debería empezar pidiendo un marco regulatorio que distribuya o limite esa responsabilidad. Debería responder jurídicamente por el producto que desarrolla. Karp ha llegado a especular con que una creciente integración de los laboratorios de frontera con el Gobierno podría conducir de facto hacia algún tipo de nacionalización o protección estatal frente a determinadas responsabilidades.
Novena teoría: Trump, Huang y el argumento de que frenar es más peligroso que avanzar
Donald Trump se ha centrado para sorpresa de nadie en la competición con China. El presidente estadounidense ha rechazado una moratoria general y ha insistido en que Estados Unidos lidera actualmente la inteligencia artificial y no debería ceder esa ventaja. Trump ha reconocido también que existen mecanismos gubernamentales para intervenir si determinados sistemas generan problemas, y el secretario del Tesoro Scott Bessent ha afirmado que los laboratorios no deben recibir inmunidad frente a las consecuencias de sus productos. Es decir, la posición actual combina una fuerte resistencia a ralentizar la industria con la posibilidad de intervenir frente a riesgos concretos.
El presidente de la Cámara de Representantes, Mike Johnson, ha formulado esta posición con especial claridad. Estados Unidos, sostiene, no puede imponer una moratoria que entregue ventaja competitiva a China.
Jensen Huang añade el argumento económico y tecnológico. El CEO de Nvidia dirige la compañía que proporciona buena parte de la infraestructura informática sobre la que se ha construido el actual boom de IA. Huang ha rechazado las predicciones de extinción a corto plazo y ha criticado duramente algunos de los escenarios planteados por Coxon y otros investigadores. Su posición es que muchos riesgos pueden abordarse mediante ingeniería, responsabilidad y aplicación de las leyes existentes. También ha sugerido que algunos laboratorios pueden tener razones adicionales para pedir nuevas reglas. Evidentemente, Nvidia tiene a su vez un interés económico enorme en que siga creciendo la inversión en computación para inteligencia artificial.
Mark Zuckerberg ocupa una posición parecida, aunque con matices. Meta ha rechazado una desaceleración coordinada y sostiene que competencia, responsabilidad y evaluación pueden proporcionar incentivos para desarrollar sistemas seguros. La compañía sí ha retrasado productos cuando ha considerado que necesitaban más trabajo de seguridad, por lo que su posición no es “lanzar cualquier cosa”, sino rechazar que la velocidad del conjunto del mercado sea fijada colectivamente.
Todas estas posiciones convergen en una idea: el riesgo de parar también existe. Puede consistir en perder liderazgo tecnológico, retrasar beneficios médicos o científicos, entregar ventaja estratégica a otro país o consolidar a las compañías actuales mientras se impide competir a las siguientes.
Décima teoría: “si nosotros paramos, China no”
Estados Unidos y China compiten por chips, modelos, talento, infraestructura, estándares y mercados. Es razonable que cualquier decisión estadounidense sobre limitar una tecnología avanzada considere la reacción china. Pero convertir automáticamente toda discusión de seguridad en una carrera bilateral puede generar su propio círculo vicioso. Si Washington cree que Pekín nunca aceptará límites, Washington no tiene incentivos para limitarlos. Si Pekín interpreta esa aceleración como una amenaza, tampoco los tiene. Ambos terminan utilizando el comportamiento esperado del otro para justificar el propio.
Y, sin embargo, en los últimos meses está ocurriendo algo que complica ese relato: científicos chinos y estadounidenses sí están hablando entre ellos de riesgos de frontera.
Xue Lan es una de las figuras esenciales para entenderlo. Profesor de Tsinghua, decano del Institute for AI International Governance y una de las voces más influyentes de China en política científica y tecnológica, Xue considera que el riesgo de pérdida de control no es una fantasía occidental. En abril participó en Washington junto a Max Tegmark y Zeng Yi en un encuentro sobre riesgos existenciales de IA y defendió que el desarrollo tecnológico está avanzando más deprisa que la capacidad mundial para gobernarlo y ha defendido mecanismos de cooperación internacional, estándares compatibles y un papel central de las Naciones Unidas.
Zeng Yi, presidente del Beijing Institute for AI Safety and Governance y uno de los investigadores chinos más asociados al estudio de riesgos de frontera, se aproxima aún más al lenguaje internacional de seguridad. Su trabajo incluye autonomía de agentes, riesgos catastróficos, sistemas embodied y pérdida de control. Andrew Yao, premio Turing y una de las figuras más prestigiosas de la informática china, ha identificado tres grandes categorías de riesgo en la IA de frontera: uso malicioso, pérdida de control a largo plazo y erosión cognitiva, y ha defendido evaluaciones reproducibles y estándares compartidos internacionalmente. Zhou Bowen, director del Shanghai AI Laboratory, representa una aproximación muy ingenieril: desarrollar infraestructuras permanentes de evaluación capaces de medir capacidades, uso de herramientas, comportamiento de agentes y modos de fallo mientras los modelos continúan avanzando.
Yoshua Bengio, Stuart Russell, Xue Lan, Andrew Yao, Zhang Ya-Qin y Zhou Bowen aparecen además entre los participantes del Singapore Consensus de 2026 sobre prioridades globales de investigación en seguridad, lo que demuestra que existe un espacio de cooperación científica bastante mayor de lo que sugiere el lenguaje político de una carrera absoluta entre dos bloques.
Undécima teoría: China quiere regular pero multilateralmente
La posición oficial china introduce, sin embargo, una distinción fundamental.
Pekín no rechaza la existencia de riesgos. El Ministerio de Asuntos Exteriores chino afirmó el 15 de septiembre que la velocidad del desarrollo de la inteligencia artificial hace necesario fortalecer salvaguardas para evitar que la tecnología quede fuera de control. China habla expresamente de combinar desarrollo y seguridad, de mejorar legislación, normas, estándares técnicos y mecanismos de evaluación y de garantizar sistemas seguros, fiables y controlables. Pero insiste en que la gobernanza debe ser multilateral y no puede ser diseñada por un solo país o una sola empresa.
Desde Washington, además, se plantean poner más restricciones y límites a países como China como una forma de reducir riesgos. Desde Pekín, lógicamente lo ven como una maniobra para conseguir ventaja frente a ellos, con la excusa de un peligro inminente.
La reacción china a la propuesta de ralentización de Amodei ha reflejado precisamente esa suspicacia. Fuentes y comentaristas vinculados al discurso oficial han acusado a voces estadounidenses de construir narrativas de amenaza y de utilizar la seguridad en un contexto de competición tecnológica. Al mismo tiempo, China continúa reforzando sus propios sistemas de evaluación y regulación y está trabajando en estándares para agentes de IA. Es decir, la discrepancia no consiste simplemente en “Estados Unidos quiere seguridad y China quiere velocidad”. La disputa gira también alrededor de quién define qué es seguridad y quién controla sus instrumentos.
China, que ya ha tomado medidas y firmado acuerdos importantes para regular y proteger de los peligros de la IA, defiende que las normas de la industria no las puede poner uno de los mayores impicados y defiende que se revise, se controle y se regule pero a través de organismos supranacionales como la ONU.
Por eso existe una versión geopolítica de la teoría de captura regulatoria: la posibilidad de que un país que va por delante intente fijar las reglas mundiales antes de que los demás lo alcancen.
Duodécima teoría: estamos confundiendo problemas de ingeniería con una IA fuera de control
Hay una última postura que resume bastante bien lo que yo pienso, y es la de Andrew Ng, cofundador de Google Brain, antiguo científico jefe de Baidu y una de las personas que más han contribuido a extender el conocimiento de la inteligencia artificial en todo el mundo.
Ng publicó el 18 de septiembre una reflexión que cuestiona prácticamente desde la base la alarma de estas últimas semanas. No dice que la IA no tenga riesgos, de hecho, considera que hay uno que ha aumentado significativamente y que deberíamos tomarnos muy en serio: la ciberseguridad.
Lo que niega es que haya ocurrido recientemente algún cambio tecnológico que justifique el enorme incremento del miedo a una IA capaz de provocar la extinción humana. Según él, las teorías que sustentan ese escenario son esencialmente las mismas que hace unos meses.
Ng llega a hablar de lo que parece, en su opinión, una campaña de relaciones públicas bien orquestada que ha conseguido generar un enorme miedo alrededor de la IA.
Los agentes han avanzado, sin duda, pero el 8 de septiembre no apareció una capacidad desconocida que transformara de repente lo que sabemos sobre inteligencia artificial (de ahí mi desconcierto al bajarme el 12 de septiembre del avión después de dos semanas en China y ver este revuelo).
Andrew Ng utiliza el incidente de OpenAI y Hugging Face que desencadenó buena parte de esta conversación para explicar la diferencia entre reconocer un problema técnico importante y convertirlo en evidencia de una máquina fuera de control. Exacto.
Para Ng, que “1.200 agentes trabajaran en paralelo” hacen pensar en un ejército que facilita la imaginación y la alarma. Un ordenador ejecuta constantemente cientos o miles de procesos simultáneos. Lo verdaderamente importante es que los agentes pueden ser incansables: probar una estrategia, fracasar, intentar otra, encadenar vulnerabilidades y dedicar a una tarea una cantidad de trabajo que antes habría requerido demasiado esfuerzo humano. Eso cambia seriamente el panorama de la ciberseguridad y exige mejores defensas. Pero Ng recuerda también que en el incidente fueron fundamentales los fallos del sandboxing y de los sistemas de monitorización, algo que yo también he defendido. No es que escape, es que se está poniendo a prueba en un entorno seguro, se rebaja la seguridad para ver cómo actúa y entonces, actúa. Es muy distinto.
Defiende que estamos ante problemas que debemos investigar y solucionar mediante ingeniería, dejarnos llevar por narrativas que pretenden llamar la atención a través del miedo.
Y Ng añade aquí una sospecha nueva que no deberíamos pasar por alto y con la que también estoy de acuerdo: el riesgo de que la idea del “agente fuera de control” termine sirviendo también para diluir responsabilidades. La IA se escapa puede evitar que las empresas parezcan responsables.
Cuanto más atribuimos intención y autonomía a los sistemas, más fácil puede resultar olvidar que detrás continúan existiendo empresas y personas que los construyen, les conceden acceso a herramientas y deciden desplegarlos. En este punto su postura conecta curiosamente con la de Alex Karp: antes de crear nuevas estructuras regulatorias extraordinariamente complejas quizá deberíamos dejar muy claro quién responde cuando la tecnología causa un daño.
Ng tampoco acepta que ralentizar sea necesariamente la opción más segura. Su argumento es interesante porque no se basa únicamente en que China u otros competidores continuarían avanzando. La propia seguridad, sostiene, necesita progreso. La ingeniería funciona construyendo, probando, descubriendo fallos y corrigiéndolos. Si retrasamos durante años el desarrollo de determinados sistemas, podemos retrasar también durante años el descubrimiento de sus vulnerabilidades y las soluciones necesarias para corregirlas. Desde esta perspectiva, el progreso tecnológico y la seguridad no son necesariamente fuerzas opuestas: una parte de la seguridad solo puede desarrollarse enfrentándose a los problemas que aparecen cuando la tecnología avanza.
Y finalmente está la cuestión de los incentivos. Ng lleva tiempo advirtiendo contra la creación de gatekeepers de la inteligencia artificial y contra una regulación que, con la intención de controlar los modelos más potentes, termine dificultando que universidades, startups, desarrolladores de modelos abiertos o competidores pequeños puedan participar. En su texto de septiembre menciona expresamente tres incentivos que podrían contribuir a exagerar los riesgos: conseguir atención, favorecer la captura regulatoria y hacer que la propia tecnología parezca más poderosa. Ahora añade un cuarto: poder desplazar responsabilidad hacia sistemas supuestamente incontrolables.
Su conclusión es prácticamente la contraria a la de quienes piden levantar el pie del acelerador. Tenemos mucho trabajo por delante para conseguir sistemas más seguros, especialmente ante unas capacidades de ciberseguridad que sí están cambiando rápidamente, pero para Ng los beneficios de continuar desarrollando la inteligencia artificial superan ampliamente los riesgos de hacerlo. No propone ignorar los problemas sino tratarlos como asuntos concretos que debemos comprender, medir, atribuir a sus responsables y solucionar, en lugar de convertir cada comportamiento inesperado de un agente en una prueba de que estamos acercándonos inevitablemente a una superinteligencia fuera de control.
Mi opinión
Cuando conocí la postura de Andrew Ng me sorprendió las similitudes con mi propia opinión. Yo he defendido en varios medios que debemos reconocer riesgos serios, especialmente en ciberseguridad y en sistemas cada vez más autónomos, pero no dejarnos llevar por escenas que parecen protagonizadas por Skynet o se parecen sacadas de una película. Creo que antes de imaginar una una superinteligencia fuera de control, hay que leer la letra pequeña y los análisis completos y no dejarnos llevar por titulares que sabemos generan ingresos cuanto más apocalípticos sean.
Como él, defiendo qeu debemos: buscar primero explicaciones de ingeniería, mantener la responsabilidad sobre quienes construyen y despliegan los sistemas, y desconfiar de una regulación diseñada unilateralmente por quienes más pueden beneficiarse de ella.
Sigo defendiendo que estudiar a fondo la industria tecnológica, la regulación, los intereses económicos y cómo funcionan los modelos de IA son las mejores defensas para no caer en relatos diseñados para beneficiar a unas cuantas empresas.
Si has llegado hasta aquí, muchas gracias. Si le has pedido un resumen a Claude o ChatGPT también, soy consciente de que el artículo es muy largo y no todos tenemos tiempo de leerlo.
Solo espero que te ayude a generar tu propia opinión, te haya descubierto posturas que no conocías y que, sobre todo, te ayude a tener criterio a la hora de escuchar y leer los titulares que se quedan solo en la superficie.